 TF-IDF求取文本相似度
原文链接:https://blog.csdn.net/qq_39355828/article/details/116783236 (opens new window)
# TF-IDF求取文本相似度
# 1.需求
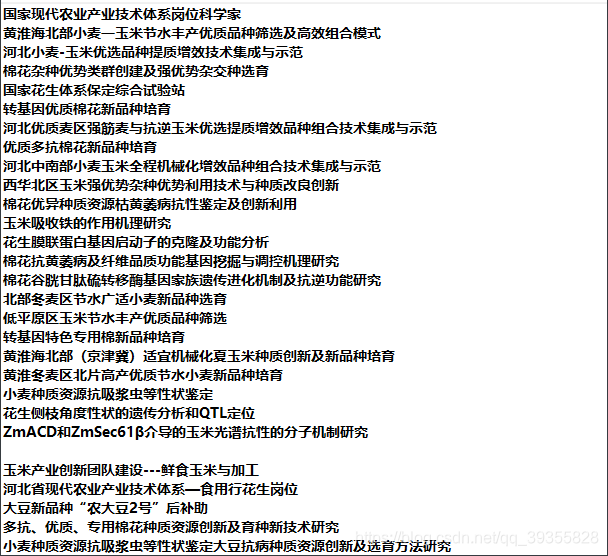
有目标文本和许多的待检测文本,需要求得的是目标文本与其他文本的相似度。有停止词。
待检测文本如下:
目标文本:
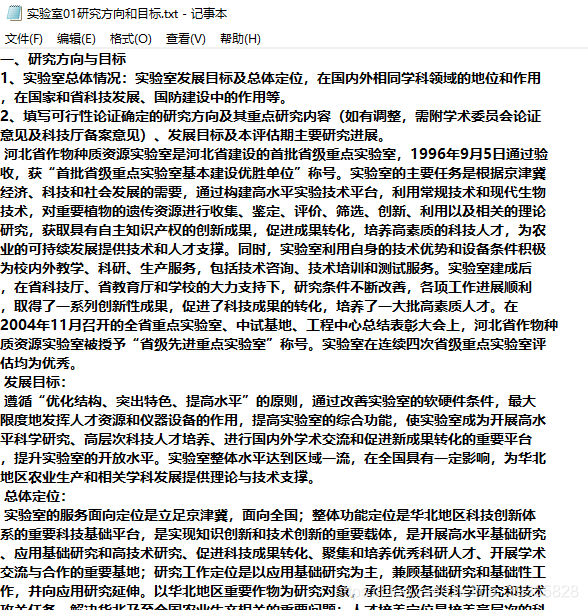
要求取的是目标文本与待检测版本的相似度
# 2.TF-IDF算法求解相似度
#-*- encoding:utf-8 -*-
import jieba
from gensim import corpora, models, similarities
import heapq
import os
import json
import pandas as pd
import operator

class Qa:
    stopwords_file = 'stopwords.txt'
    stopWordsList = '停用词.txt'

    with open(r'实验室01项目.txt', 'r', encoding='utf-8') as file:

        content_list = file.readlines()  # 读取所有行并返回列表
    questionList = [x.strip() for x in content_list]
    print(questionList)

    # load stop_words
    def load_stop_words(self)->list:
        with open(self.stopwords_file, mode="r", encoding="utf-8") as f:
            content = f.read()
        content_list = content.split('\n')
        self.stopWordsList = content_list
        return self.stopWordsList

    #delete question list stopwords 删除词组列表中的停用词
    def delete_stop_words(self, wordsList:list) -> list:
        """
        :param wordsList: 列表
        :return: list
        """
        newWords = []
        for word in wordsList:
            if word not in self.stopWordsList:
                newWords.append(word)
        return newWords

    #question list
    def get_question_list(self):
        """
        可从数据库文本等 获取
        :return: list
        """
        questionList = self.questionList

        #将question list 分词并去除停用词
        result = [self.delete_stop_words(jieba.lcut(val)) for val in questionList]
        #print(result)
        return result

    #run
    def run(self, question: str) -> list:

        #1. 加载语料
        #load stop words
        self.load_stop_words()
        #get question list
        questionList = self.get_question_list()

        #delete stop words for input question
        question = self.delete_stop_words(wordsList=jieba.lcut(question))

        #2. 生成词典
        # 生成gensim 词典
        dictionary = corpora.Dictionary(questionList)
        print(dictionary)
        #3. 通过doc2bow 稀疏向量生成语料库
        corpus = [dictionary.doc2bow(item) for item in questionList]
        #4. 计算tf值
        tf = models.TfidfModel(corpus)
        # 5.通过token2id得到特征数(特征数:字典里面的键的个数)
        #dictionary.token2id: {'title': id}
        numFeatures = len(dictionary.token2id.keys())
        #计算稀疏矩阵相似度 建立索引
        index = similarities.MatrixSimilarity(tf[corpus], num_features=numFeatures)

        #生成新的稀疏向量  根据原有的dictionary 生成新的 稀疏向量
        newDec = dictionary.doc2bow(question)
        # result
        simsQuestion = index[tf[newDec]]

        #
        result = []
        #
        result1 = []
        for val in list(enumerate(simsQuestion)):
            if val[1] < 0.05:
                result1.append({
                    '项目': str(self.questionList[val[0]]),
                    '相似度': val[1],
                    '位置': val[0],
                })
        print(result1)
        file = open('data5.txt', 'w')
        file.write(str(result1));
        file.close()
        #
        for val in list(enumerate(simsQuestion)):
            if val[1] > 0:
                result.append({
                    '项目': str(self.questionList[val[0]]),
                    '相似度': val[1],
                    '位置': val[0],
                })
        print(result)
        file = open('data.txt', 'w')
        file.write(str(result));
        file.close()
        exit()

if __name__ == '__main__':
    Qa = Qa()
    text = open("实验室01研究方向和目标.txt", encoding="utf-8").read()
    Qa.run(text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
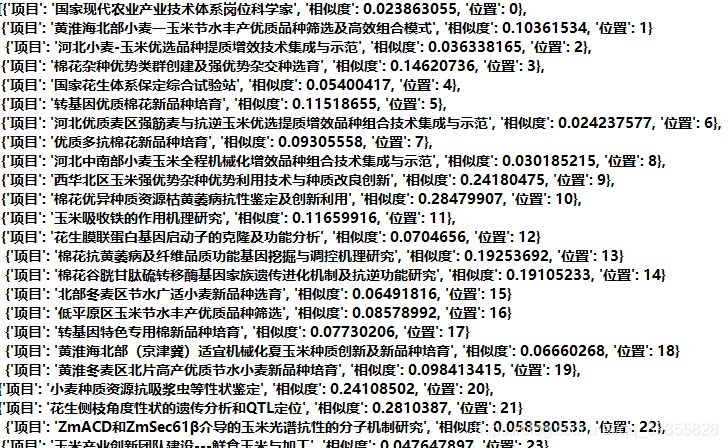
# 3.输出结果
编辑 (opens new window)
上次更新: 2026/08/11, 13:36:18